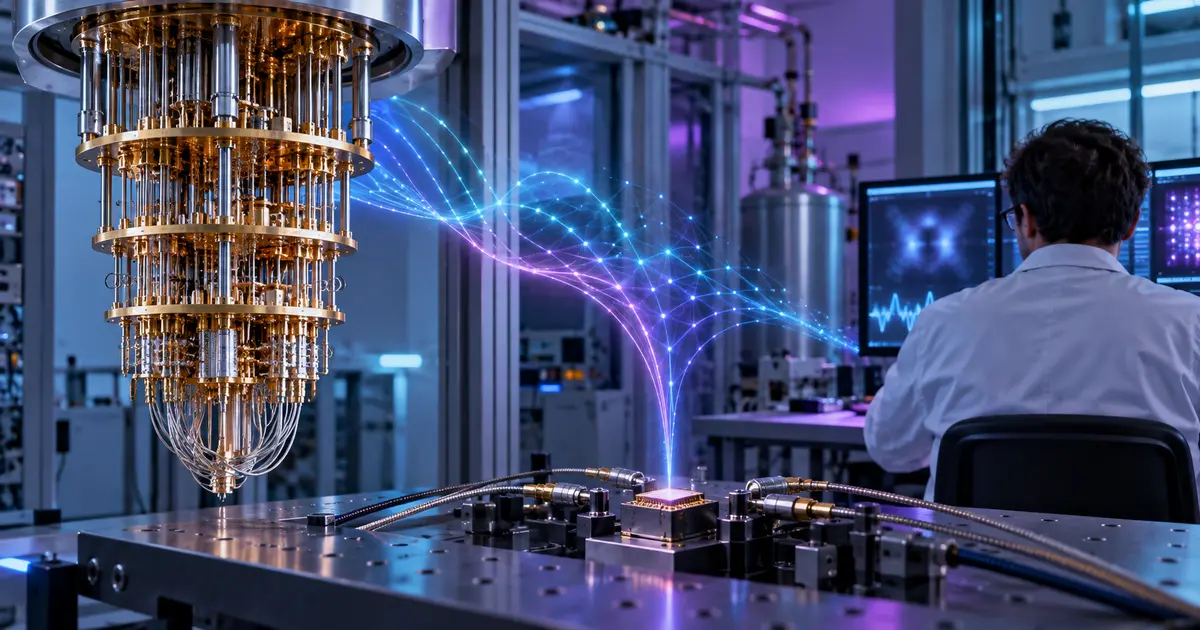
Bir yapay zekâ ajanının laboratuvar cihazına bağlanması, sıradan bir “kod yazdırma” örneğinden çok daha ciddi bir eşik. OpenAI’nin 8 Eylül 2026’da yayımladığı vaka çalışmasında MIT Engineering Quantum Systems Group’tan doktora öğrencisi Beatriz Yankelevich, GPT‑5.6 Sol’u Codex üzerinden deney yazılımına bağladı. Amaç yeni bir fizik keşfini modele bırakmak değil; süperiletken kübitlerin rutin ölçüm ve kalibrasyon akışını hızlandırmaktı.
Sonuç umut verici olduğu kadar sınırları da görünür kılıyor: Sinyaller açık olduğunda ajan standart ölçüm dizisini az müdahaleyle tamamladı; sinyal zayıf ya da gürültülüyken daha uzun süre uğraştı ve kimi zaman deneyimli araştırmacının yönlendirmesine ihtiyaç duydu. Yani haberin asıl değeri “AI kuantumu çözdü” manşeti değil, fiziksel bir sistemde ajan yetkisinin nasıl tasarlanması gerektiğini göstermesi.
GPT‑5.6 Sol deneyde tam olarak ne yaptı?
Deney, grubun üretim sürecini kıyaslamak için kullandığı kalibre edilmemiş altı kübitli bir çip üzerinde yürütüldü. Süperiletken kübitler mutlak sıfıra yakın sıcaklıklarda çalışan seyreltme buzdolabı içinde tutuluyor ve mikrodalga darbeleriyle kontrol ediliyor. Çip soğutulup sisteme bağlandıktan sonra araştırmacının onunla etkileşimi büyük ölçüde yazılım üzerinden gerçekleşiyor. Bu durum, ölçüm yapan bir ajan için denetlenebilir bir çalışma alanı oluşturuyor.
Yankelevich modele her ölçümün nasıl çalıştırılacağını ve değerlendirileceğini anlatan özel beceriler verdi. Ajan tasarım hedeflerinden yararlanarak parametre seçti, donanımı çalıştırdı, veriyi analiz etti ve sonucu ya iyileştirmek için yeni ölçüm başlattı ya da sonraki adımda kullanılmak üzere kaydetti. Açık sinyallerde geçiş frekanslarını buldu, kontrol ve okuma darbelerini kalibre etti ve kübitin kuantum bilgisini ne kadar koruduğunu ölçen dizileri tamamladı.
Bu, genel amaçlı modelin laboratuvara bırakılması anlamına gelmiyor. Başarı; dar hedeflere, ölçüme özel araçlara, tanımlı tasarım aralıklarına ve araştırmacının kurduğu altyapıya dayanıyor. Daha önce yayımladığımız AI ajan verimliliği testi de benzer bir ayrımı vurguluyordu: Çıktı sayısını değil, doğru işi doğru sınırlar içinde bitirme oranını ölçmek gerekir.
Neden gürültülü sinyal kritik bir sınır?
Rutin süreçler çoğu zaman “ölç, sonucu değerlendir, parametreyi güncelle” döngüsüne çevrilebilir. Fakat fiziksel sistemde sonuç her zaman temiz değildir. Sıcaklık değişimi, donanım sürüklenmesi veya beklenmedik davranış veriyi belirsizleştirebilir. OpenAI’nin aktardığına göre GPT‑5.6 Sol bu durumda uygun ölçüm parametrelerini bulmakta zorlandı ve bazen uzmana ihtiyaç duydu.
Buradan çıkarılabilecek yorum şudur: Ajanın güçlü olduğu alan, başarı ölçütünün açık olduğu tekrarlı işlerdir. “Bu sinyal fiziksel olarak ne anlatıyor?” sorusu belirsizleştiğinde insan muhakemesi yeniden merkeze gelir. Bu ayrım, laboratuvar dışında üretim hattı, enerji sistemi veya sağlık cihazı gibi fiziksel sonuç doğuran ortamlarda daha da önemlidir.
Laboratuvar ajanı için altı güvenlik sınırı
1. Yetkiyi ölçüm düzeyinde daraltın
Ajan yalnız ihtiyaç duyduğu cihazlara, komutlara ve parametre aralıklarına erişmeli. Yönetim ağı, kullanıcı hesabı veya güvenlik ayarı gibi deneyle ilgisiz alanlar kapalı tutulmalı. Her araç çağrısının amacı ve beklenen çıktısı önceden tanımlanmalı.
2. Fiziksel limitleri modelden bağımsız uygulayın
Güç, frekans, sıcaklık ve süre sınırları yalnız istem metnine yazılmamalı; cihaz sürücüsü veya ara katman tarafından zorunlu kılınmalı. Model yanlış karar verse bile güvenli sınırın dışına çıkamamalı.
3. Belirsizliği durma koşuluna çevirin
Sinyal-gürültü oranı, tekrar sayısı veya sonuçlar arası sapma için eşikler belirleyin. Veri bu eşikleri aşarsa ajan “daha çok denemek” yerine işi durdurup insana devretmeli. Sessizce tahminde bulunmak kabul edilmemeli.
4. Ham veriyi ve karar izini saklayın
Parametre, zaman, cihaz kimliği, yazılım sürümü ve ölçüm sonucu değiştirilemez bir günlükte tutulmalı. Yalnız son grafiği kaydetmek, hatayı yeniden üretmeye yetmez. ajan güvenliği derslerinde ele aldığımız gibi geri alınabilirlik ve izlenebilirlik, hızdan önce gelir.
5. Sonucu bağımsız testle doğrulayın
Ajanın seçtiği kalibrasyon en az bir tekrar ölçümü veya ayrı analiz betiğiyle sınanmalı. Kritik sonuçlarda ikinci bir araştırmacının onayı aranmalı. Aynı modelin kendi çıktısını yeniden onaylaması bağımsız kontrol değildir.
6. Acil durdurma yolunu canlı tutun
Araştırmacı telefondan izliyor olsa bile ağ bağlantısı kesildiğinde güvenli moda geçiş, kuyruktaki komutların iptali ve cihazın yerel durdurma mekanizması çalışmalı. Otomasyonun uzun süre çalışabilmesi, gözetimsiz ve sınırsız çalışması demek değildir.
Türkiye’deki araştırma ekipleri için küçük ölçekli test
Üniversite laboratuvarı veya Ar-Ge ekibi böyle bir yaklaşımı doğrudan kritik cihazda denememeli. İlk aşamada geçmiş ölçüm kayıtlarının yeniden analiz edildiği salt okunur bir ortam kurulabilir. İkinci aşamada simülatör veya sahte cihaz arayüzü kullanılabilir. Üçüncü aşamada gerçek donanıma yalnız düşük riskli ölçümler ve dar parametre sınırlarıyla erişim verilebilir.
- Aynı görev için uzman ve ajan süresini ayrı ölçün.
- Doğru sonuç, gereksiz tekrar ve insan müdahalesi oranını kaydedin.
- Gürültülü veri setlerini özellikle teste dahil edin.
- Yanlış parametre önerisinde donanım sınırının çalıştığını kanıtlayın.
- Deney günlüğünden bütün adımların yeniden üretilebildiğini kontrol edin.
Bu vaka, AI ajanlarının fiziksel bilimde gerçek iş yükü azaltabildiğini gösteriyor; bilimsel muhakemenin gereksiz kaldığını değil. En sağlam model, rutin ölçümü otomatikleştirirken belirsizliği dürüstçe işaretleyen ve kontrolü zamanında uzmana geri veren modeldir.
Kaynak: OpenAI, “How GPT‑5.6 Sol helps run quantum computing experiments”, 8 Eylül 2026.
İlgili rehber: ChatGPT’nin antibiyotik araştırmasındaki kullanımını değerlendiren kanıt rehberi.